Google oficjalnie zaprezentowało model Gemini 4 Neon — nową generację modelu multimodalnego zaprojektowaną z myślą o szybkim wykonywaniu złożonych zadań w inżynierii oprogramowania, pracy analitycznej oraz badaniach naukowych. Model oferuje okno kontekstu o pojemności 1 miliona tokenów, cztery konfigurowalne poziomy wnioskowania, zniżkę 95% na tokeny z pamięci podręcznej w API oraz czołowe lokaty w zestawieniach Artificial Analysis i Vals Index. Sprawdzamy pełny, potwierdzony cennik, dostępność oraz praktyczne znaczenie dla programistów i firm.
Multimodalne okno 1 miliona tokenów i cztery poziomy myślenia
Według oficjalnego ogłoszenia Google, Gemini 4 Neon powstał z myślą o połączeniu wysokiej szybkości działania z obsługą wieloetapowych przepływów agentowych i programistycznych. Okno kontekstu mieszczące 1 milion tokenów pozwala syntetyzować w jednej sesji duże zbiory zróżnicowanych materiałów: kod źródłowy, arkusze kalkulacyjne, dokumenty PDF, wykresy, a także nagrania audio i wideo.
Istotnym usprawnieniem dla zespołów inżynieryjnych są cztery poziomy wnioskowania (thinking levels), które pozwalają płynnie skalować głębokość rozumowania oraz zużycie tokenów w zależności od trudności zadania — od szybkich operacji po najgłębszy tryb xhigh przeznaczony dla złożonych problemów inżynieryjnych i naukowych. To naturalne rozwinięcie rodziny modeli, którą omawialiśmy wcześniej w tekście Gemini 4 Hydrogen od Google — co nowego, cena API i Search.
Oficjalny cennik Gemini 4 Neon API i gdzie model jest dostępny
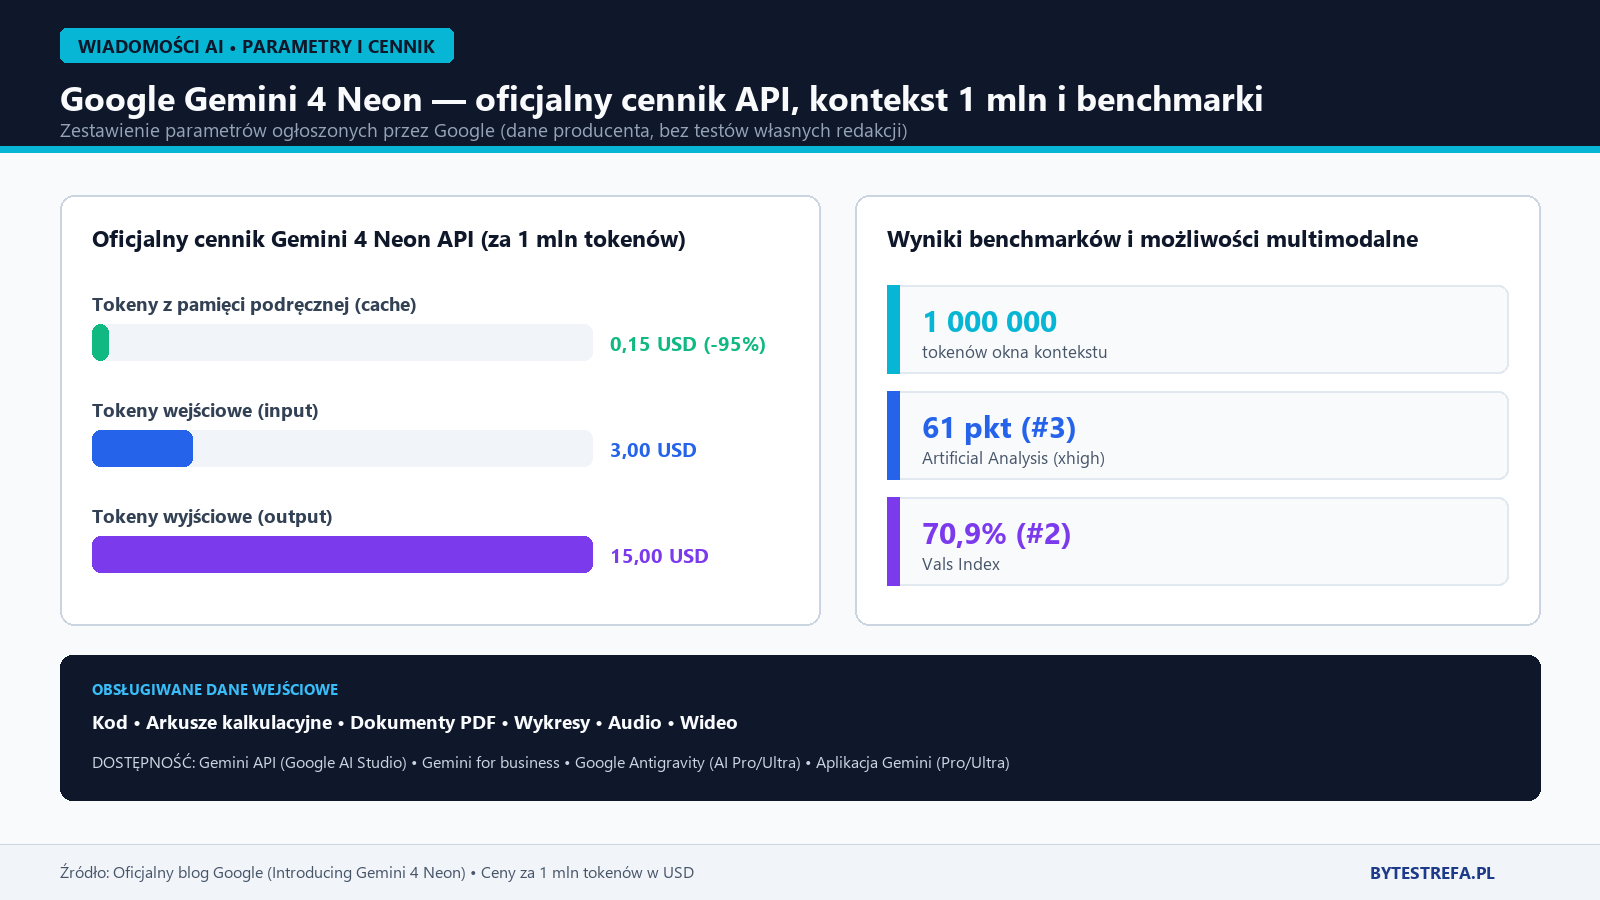
Google ujawniło przejrzysty cennik dla twórców oprogramowania korzystających z interfejsu API (stawki za 1 milion tokenów):
| Element rozliczenia API | Cena oficjalna (za 1 mln tokenów) | Uwagi z komunikatu Google |
|---|---|---|
| Tokeny wejściowe (input) | 3 USD | Standardowa stawka wejściowa |
| Tokeny z pamięci podręcznej (cache) | 0,15 USD | Zniżka 95% względem stawki podstawowej |
| Tokeny wyjściowe (output) | 15 USD | Generowanie odpowiedzi modelu |
Największą zmianą z punktu widzenia ekonomiki wdrożeń jest stawka 0,15 USD za milion tokenów z pamięci podręcznej (95% taniej niż standardowe wejście). W wieloetapowych aplikacjach agentowych oraz narzędziach programistycznych, które wielokrotnie odwołują się do tej samej bazy kodu, dokumentacji lub instrukcji systemowych, efektywne wykorzystanie prompt cachingu radykalnie obniża koszt każdego kolejnego kroku.
Google potwierdziło udostępnienie Gemini 4 Neon w czterech kanałach: w Gemini API w Google AI Studio, w pakiecie Gemini for business (przez API oraz wybór modelu), w środowisku Google Antigravity (dla płatnych subskrybentów Google AI Pro i Ultra) oraz w aplikacji Gemini dla planów Pro i Ultra.
Wyniki w benchmarkach ogólnych i programistycznych oraz ich ograniczenia
W oficjalnym komunikacie Google przytoczyło wyniki Gemini 4 Neon w zewnętrznych rankingach inteligencji ogólnej oraz testach kodowania agentowego:
- Artificial Analysis Intelligence Index (poziom myślenia xhigh): wynik 61 punktów, co daje 3. miejsce w klasyfikacji ogólnej, tuż za większymi i wolniejszymi modelami.
- Vals Index: rezultat 70,9% oraz 2. miejsce w rankingu ogólnym (na granicy efektywności Pareto).
- Artificial Analysis Coding Agent Index oraz testy inżynieryjne: 1. miejsce w rankingu Coding Agent Index z wynikiem 58,6 pkt, a w benchmarku SWE-sweep wynik 12,8% w środowisku mini-SWE oraz 39,0% w środowisku Google Antigravity.
Z perspektywy zespołów wdrożeniowych należy pamiętać, że są to rezultaty opublikowane w komunikacie producenta, a najwyższy wynik w Artificial Analysis Intelligence Index dotyczy trybu xhigh, który zużywa więcej tokenów wnioskowania. Ogłoszenie nie podaje surowych rozkładów opóźnień (TTFT i liczby tokenów na sekundę) dla poszczególnych regionów chmurowych ani nie zastępuje ewaluacji na własnych danych produkcyjnych firmy.
Podsumowanie redakcji
Gemini 4 Neon łączy pojemne, multimodalne okno kontekstu 1 mln tokenów z bardzo niską stawką za pamięć podręczną w API (0,15 USD / 1 mln tokenów) oraz czterema poziomami wnioskowania ułatwiającymi kontrolę kosztów. Dla zespołów programistycznych i analitycznych kluczowym krokiem przed migracją produkcyjną będzie porównanie kosztu i czasu wykonania pełnego zadania między domyślnym trybem high a trybem xhigh.
Deklaracja redakcyjna ByteStrefa: Wszystkie dane o możliwościach, cenach API i wynikach benchmarków pochodzą wyłącznie z oficjalnego ogłoszenia Google (blog.google). Redakcja nie przeprowadziła własnych testów laboratoryjnych modelu.

