English version: Google Gemini 4 Hydrogen: Features, API Pricing and Search
12 listopada 2026 roku Google DeepMind oficjalnie zaprezentował model Gemini 4 Hydrogen (gemini-4-hydrogen), zaprojektowany jako szybki i oszczędny model roboczy do codziennego programowania, pracy z dokumentami oraz wieloetapowych zadań agentowych. Podczas gdy flagowe modele Gemini 4 Carbon i Gemini 4 Argon skupiają się na najtrudniejszym, długim rozumowaniu, Hydrogen stawia na niskie opóźnienia i szeroką dostępność.
Według komunikatu Google DeepMind model trafił jednocześnie do wszystkich warstw Google AI Studio i Gemini API (w tym do darmowego planu Free Tier), do aplikacji Gemini, Gemini for Business, wyszukiwarki Google, a także dla subskrybentów Google AI Pro i Ultra w środowisku Google Antigravity.
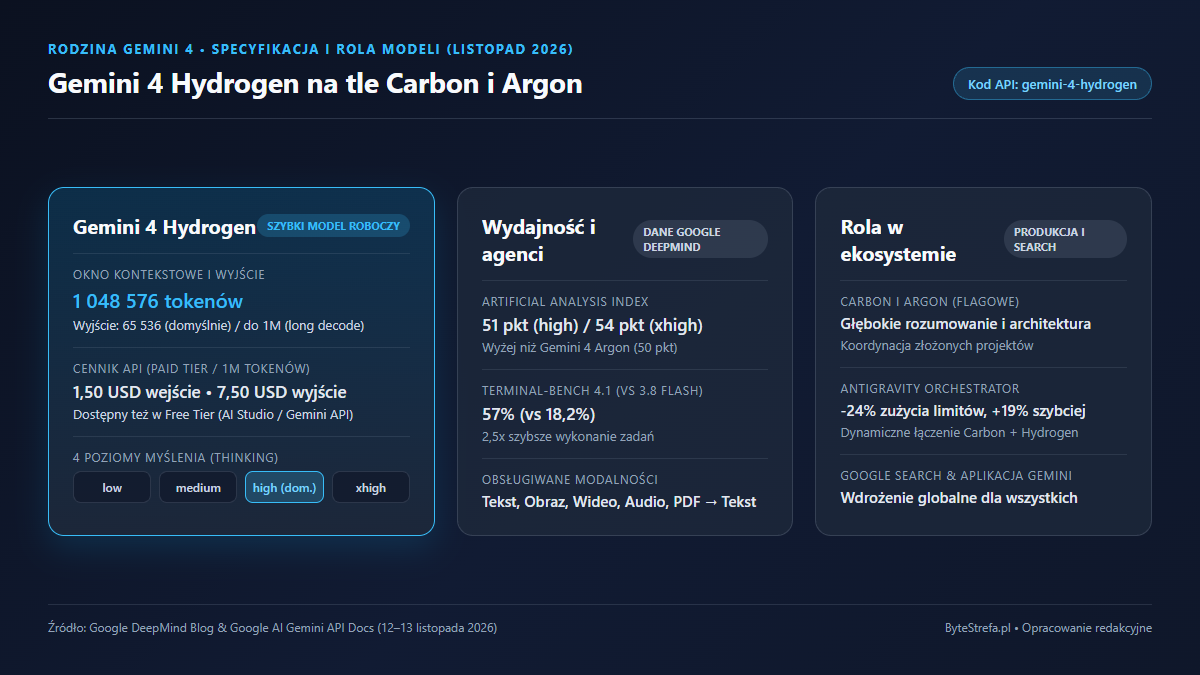
Specyfikacja, okno 1 mln tokenów i poziomy myślenia
Z oficjalnej dokumentacji Gemini API wynika, że gemini-4-hydrogen obsługuje na wejściu tekst, obrazy, wideo, audio oraz pliki PDF, generując odpowiedź tekstową. Kluczowe parametry techniczne obejmują:
- Jednolite okno kontekstowe: 1 048 576 tokenów (obejmujące wejście i wyjście).
- Maksymalne wyjście: domyślnie 65 536 tokenów w trybie synchronicznym oraz do 1 048 576 tokenów w trybie long decode.
- Cztery poziomy myślenia (thinking levels):
low,medium,high(domyślny) oraz nowy poziomxhigh, pozwalający precyzyjnie dobierać czas reakcji i głębokość analizy do złożoności zadania. - Obsługiwane narzędzia API: wykonywanie kodu (code execution), wywoływanie funkcji (function calling), wyszukiwanie w plikach (file search), obsługa interfejsu (computer use) oraz uziemienie w Google Search i Google Maps. Model nie obsługuje natomiast generowania obrazów, generowania audio, Live API ani jawnego cache’owania kontekstu (dostępne jest wyłącznie niejawne implicit caching).
W materiałach premierowych Google DeepMind podaje, że przy domyślnym poziomie high Hydrogen osiąga 51 punktów w indeksie Artificial Analysis Intelligence Index (a na poziomie xhigh 54 punkty), wyprzedzając model Gemini 4 Argon (50 punktów). Według deklaracji producenta na teście Terminal-Bench 4.1 Hydrogen uzyskuje 57% skuteczności wobec 18,2% w Gemini 3.8 Flash, wykonując zadania 2,5 razy szybciej. Są to dane z testów opublikowanych przez Google — redakcja ByteStrefa nie przeprowadziła jeszcze własnych benchmarków w polskich środowiskach produkcyjnych.
Cennik Gemini 4 Hydrogen API i darmowy dostęp
W dokumentacji cennika Gemini API model gemini-4-hydrogen jest dostępny zarówno w darmowym planie Free Tier (gdzie dane mogą być wykorzystywane do ulepszania produktów Google zgodnie z regulaminem), jak i w płatnym Paid Tier ze stałą stawką w całym oknie 1 mln tokenów:
- Tokeny wejściowe: 1,50 USD za 1 milion tokenów.
- Tokeny wyjściowe (w tym tokeny myślenia): 7,50 USD za 1 milion tokenów.
- Niejawne cache’owanie kontekstu: 0,075 USD za 1 milion tokenów.
- Uziemienie w Google Search / Maps (Paid Tier): 5 000 zapytań miesięcznie bez opłat (wspólna pula dla modeli Gemini 3 i nowszych), a następnie 14 USD za 1 000 zapytań.
W środowisku Google Antigravity pojawił się również mechanizm Orchestrator, który dynamicznie przełącza się między modelami Carbon i Hydrogen w ramach jednej sesji. Według pomiarów Google na zestawie Terminal-Bench 4.0 takie podejście pozwoliło zbliżyć się do skuteczności samego modelu Carbon przy zużyciu limitu mniejszym średnio o 24% i czasie wykonania krótszym o 19%.
Gemini 4 Hydrogen w Google Search i Antigravity
Równolegle z premierą modelu Google ogłosiło globalne wdrożenie Gemini 4 Hydrogen w wyszukiwarce Google dla wszystkich użytkowników. Z komunikatu Robby’ego Steina (VP of Product, Google Search) wynika, że aktualizacja poprawia trzy obszary:
- Lepsze rozumienie intencji: wyszukiwarka lepiej radzi sobie z pytaniami wieloczęściowymi, potocznym językiem oraz trudnymi literówkami.
- Rozbudowane query fan-out: model wykonuje równoległe zapytania dla powiązanych podtematów, częściej kierując użytkowników do mniej oczywistych, wartościowych źródeł w sieci.
- Bardziej wizualne odpowiedzi: wyniki częściej prezentują tabele porównawcze, grafiki oraz dopasowane komponenty pomocnicze we wszystkich obsługiwanych językach trybu AI.
Zakres naszej weryfikacji i czego jeszcze nie wiemy
Niniejszy materiał powstał wyłącznie na podstawie oficjalnych komunikatów Google DeepMind, Google Search oraz dokumentacji technicznej Gemini API z 12–13 listopada 2026 roku. Redakcja ByteStrefa nie przeprowadziła własnych testów obciążeniowych API ani pomiarów jakości odpowiedzi po polsku w porównaniu z konkurencyjnymi modelami — dlatego nie publikujemy własnych wykresów opóźnień ani ocen subiektywnych.
Oficjalne źródła i dokumentacja
- Introducing Gemini 4 Hydrogen | Google DeepMind — oficjalny komunikat z 12 listopada 2026 r.
- Google Search gets a major upgrade with Gemini 4 Hydrogen | Google Blog — oficjalny wpis o zmianach w wyszukiwarce z 12 listopada 2026 r.
- Gemini 4 Hydrogen — dokumentacja modelu | Google AI for Developers — specyfikacja techniczna
gemini-4-hydrogen. - Gemini API Pricing | Google AI for Developers — oficjalny cennik Free Tier i Paid Tier.
- Gemini 4 Carbon is now available | Google DeepMind — kontekst rodziny modeli Gemini 4 z 10 listopada 2026 r.

