„Ile VRAM-u potrzeba do modelu 8B?” — to pytanie brzmi prosto, ale odpowiedź „x GB” bywa myląca. Liczba parametrów modelu to tylko jeden z czynników. O tym, czy model zmieści się w pamięci karty graficznej, decyduje rozmiar jego pliku, wybrana kwantyzacja, długość kontekstu i narzut programu.
Ten tekst tłumaczy te czynniki i pokazuje przykłady z biblioteki Ollama. Wszystkie podane rozmiary to rozmiary plików ze stron modeli w bibliotece Ollama (sprawdzone 7 października 2026 r.), a nie zużycie pamięci podczas pracy. Nie mierzyliśmy zużycia pamięci ani szybkości żadnego modelu na żadnej karcie — to przewodnik oparty na dokumentacji i zdrowym rozsądku, nie wyniki testów.
Pięć pojęć, których nie warto mylić
- Rozmiar pliku modelu — tyle miejsca model zajmuje na dysku (np. 4,9 GB dla
llama3.1:8b). To w przybliżeniu rozmiar wag, ale nie całe zużycie pamięci podczas pracy. - VRAM — pamięć karty graficznej. Modele działają najszybciej, gdy mieszczą się w niej w całości.
- RAM — pamięć systemowa. Gdy model nie mieści się w VRAM, jego część trafia do RAM, a obliczenia po części wykonuje procesor, co zwykle wyraźnie spowalnia pracę.
- Kontekst — ilość tekstu, którą model „widzi” naraz. Im dłuższy kontekst, tym więcej pamięci jest potrzebne ponad wagi modelu.
- Narzut programu — bufory i obliczenia pośrednie, które też zajmują pamięć.
Rzeczywiste zużycie pamięci jest więc większe niż rozmiar pliku: to wagi modelu plus kontekst plus narzut. Plik wielkości zbliżonej do VRAM nie wystarczy — potrzebny jest wyraźny zapas.
Dlaczego liczba parametrów nie równa się wymaganej pamięci
Kwantyzacja
Kwantyzacja to zapis wag modelu z mniejszą precyzją, co zmniejsza plik i zużycie pamięci kosztem pewnej straty jakości. Dlatego ten sam model może mieć kilka wersji o różnych rozmiarach. Przykład z biblioteki Ollama: wersje QAT modelu Gemma 3 są według opisu twórców trzykrotnie mniejsze niż wersje bez kwantyzacji, przy zachowaniu podobnej jakości jak w pełnej precyzji — to deklaracja producenta, nie nasz pomiar.
Różne modele, różne rozmiary
Modele o podobnej liczbie parametrów nie zajmują tyle samo. W bibliotece Ollama qwen3:8b ma 5,2 GB, llama3.1:8b — 4,9 GB, a gemma3:12b — 8,1 GB. Qwen 3 obejmuje zarówno modele gęste, jak i typu mixture-of-experts, a architektura też wpływa na wymagania. Sama liczba parametrów w nazwie nie wystarcza do oceny, czy model zmieści się w pamięci.
Kontekst
Według FAQ Ollama domyślny rozmiar kontekstu to 4096 tokenów (można go zmienić; domyślne ustawienia mogą się zmieniać w nowych wersjach). Wiele modeli deklaruje dużo większy kontekst — np. 128K tokenów — ale wykorzystanie go oznacza znacznie większe zużycie pamięci. Przy małej karcie lepiej zostawić krótszy kontekst.
Co się dzieje, gdy modelowi brakuje VRAM
Jeśli model nie mieści się w VRAM, część trafia do pamięci systemowej, a obliczenia po części wykonuje procesor. Polecenie ollama ps pokazuje to w kolumnie Processor (np. „100% GPU” albo podział CPU/GPU). Działa to, ale zwykle znacznie wolniej, a do tego zużywa pamięć RAM. Więcej o Ollama w tekście Ollama na Windows.
4 GB, 8 GB, 12 GB, 16 GB — rozmiary plików względem VRAM
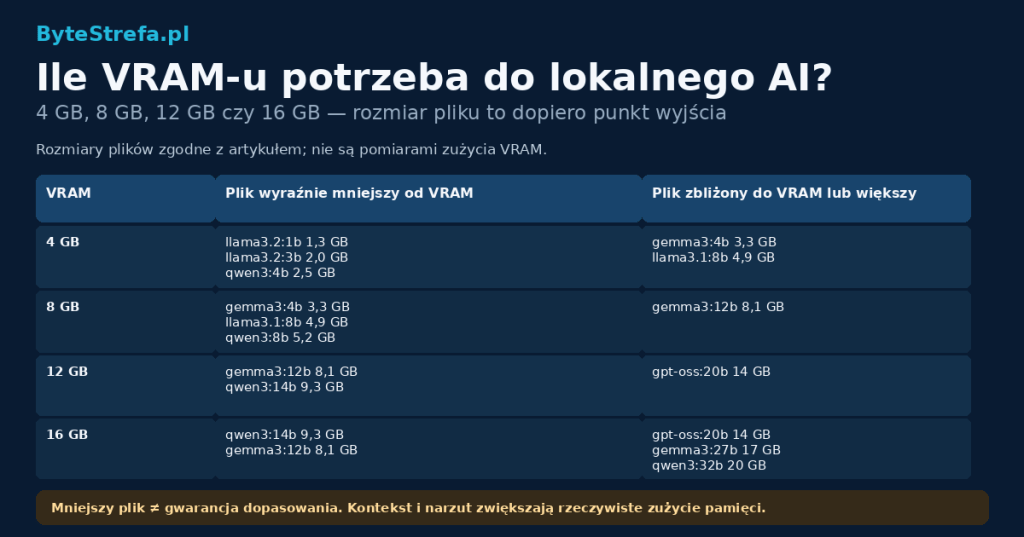
Tabela zestawia rozmiary plików przykładowych modeli z pojemnością VRAM. To tylko punkt wyjścia do oceny: rzeczywiste zużycie pamięci będzie większe niż rozmiar pliku (kontekst i narzut), więc to, czy model faktycznie zmieści się w VRAM, trzeba sprawdzić na własnym sprzęcie (ollama ps). Mniejszy plik nie gwarantuje, że model zmieści się w praktyce.
| Pojemność VRAM | Plik wyraźnie mniejszy od VRAM (jest szansa na zapas na kontekst i narzut) | Plik zbliżony do VRAM lub większy od niej |
|---|---|---|
| 4 GB | llama3.2:1b (1,3 GB), llama3.2:3b (2,0 GB), qwen3:4b (2,5 GB) |
gemma3:4b (3,3 GB) — zapas na kontekst i narzut jest niewielki; llama3.1:8b (4,9 GB) — plik większy od VRAM |
| 8 GB | gemma3:4b (3,3 GB); llama3.1:8b (4,9 GB) i qwen3:8b (5,2 GB) — zapas jest, ale zależy od kontekstu |
gemma3:12b (8,1 GB) — plik większy od VRAM |
| 12 GB | gemma3:12b (8,1 GB); qwen3:14b (9,3 GB) — zapas maleje wraz z kontekstem |
gpt-oss:20b (14 GB) — plik większy od VRAM |
| 16 GB | qwen3:14b (9,3 GB) i gemma3:12b (8,1 GB) — większy zapas na kontekst |
gpt-oss:20b (14 GB) — Ollama pisze o co najmniej 16 GB pamięci, więc zapas jest mały; gemma3:27b (17 GB) i qwen3:32b (20 GB) — pliki większe od VRAM |
Rozmiary pochodzą ze stron llama3.2, llama3.1, qwen3, gemma3 i gpt-oss. Dla gpt-oss:20b Ollama pisze, że model może działać na systemach z co najmniej 16 GB pamięci.
Co można z tym zrobić w praktyce
- 4 GB: pasują głównie małe modele, do prostych zadań i eksperymentów. Zwykle gorzej radzą sobie z trudnymi pytaniami — nie mamy na to własnych testów.
- 8 GB: może być dobrym punktem startowym dla części modeli klasy 8B przy umiarkowanym kontekście. Przy dłuższym kontekście zapas szybko się zmniejsza.
- 12 GB: daje więcej miejsca na modele klasy 12–14B albo na dłuższy kontekst przy mniejszych modelach — zależnie od konkretnego modelu.
- 16 GB: pozwala na większe modele z mniejszym kompromisem, ale modele rzędu 20–30B nadal wymagają starannego doboru wersji i sprawdzenia w praktyce.
To ogląd oparty na rozmiarach plików, nie obietnica wydajności.
Pamięć wspólna zamiast osobnego VRAM
Niektóre urządzenia nie mają osobnego VRAM. Opisywany u nas NVIDIA DGX Spark ma według producenta 64 GB zunifikowanej pamięci. Takie rozwiązanie działa inaczej niż karta z osobną pamięcią, więc nie porównuj liczb 1:1.
Jak wybrać kartę do lokalnego AI
- Zacznij od modeli, których chcesz używać, i sprawdź rozmiary ich plików.
- Dodaj zapas na kontekst i narzut.
- Porównaj z VRAM kart — np. opisane u nas karty GeForce RTX z serii 50 czy RTX 5090 z 32 GB GDDR7 (dane producenta).
- Przy ograniczonym budżecie więcej VRAM zwykle liczy się bardziej niż kilka procent szybszy układ — bo model, który się nie mieści, zwalnia.
- Pamiętaj o koszcie energii przy pracy całodobowej: jak go policzyć.
Ograniczenia
Rozmiary plików ze stron biblioteki Ollama mogą się zmieniać wraz z nowymi wersjami modeli. Nie mierzyliśmy zużycia VRAM ani szybkości na żadnym sprzęcie. Liczby w tabeli służą do orientacji, nie do rekomendowania konkretnych kart.
Zobacz także
- Ollama na Windows — instalacja, modele i wymagania sprzętowe
- Mini PC czy NAS — co lepiej sprawdzi się jako domowy serwer?
- Pamięci drożeją przez AI — dlaczego sprzęt może kosztować więcej


Dodaj komentarz