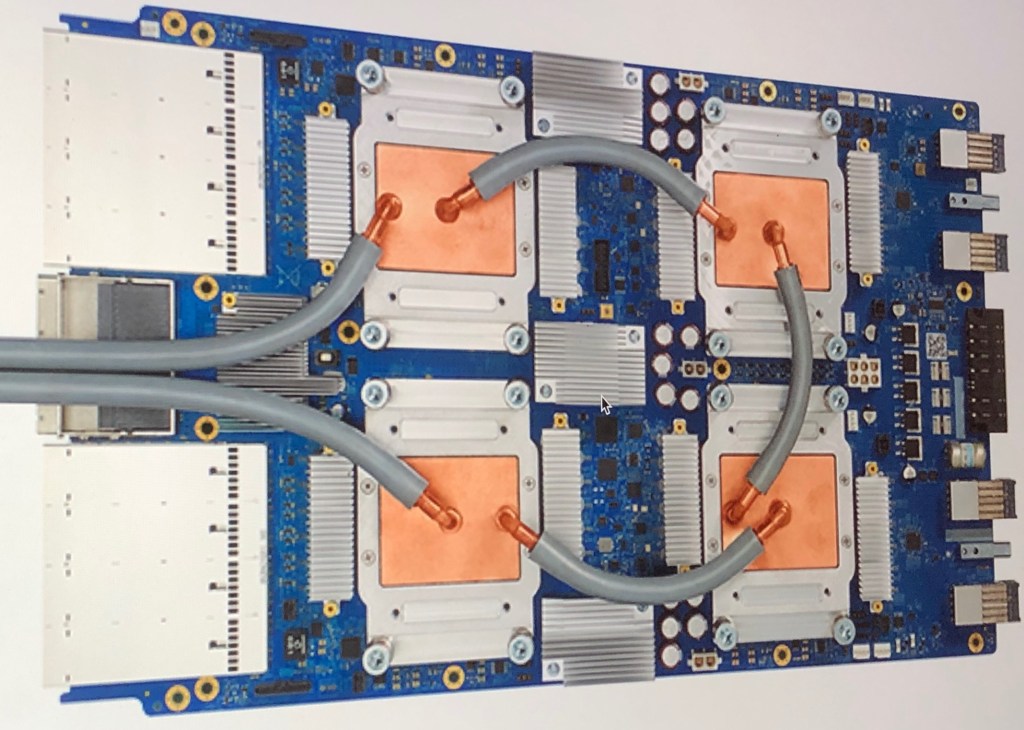
Wstęp
W miarę jak sztuczna inteligencja (AI) staje się coraz bardziej powszechna, rosną również wymagania dotyczące mocy obliczeniowej. Google opracował architekturę TPU (Tensor Processing Unit), zaprojektowaną specjalnie do przyspieszania obliczeń związanych z uczeniem maszynowym. W artykule przyglądamy się architekturze TPU v3, ze szczególnym uwzględnieniem macierzy skurczowych oraz chłodzenia cieczą. Wszystkie podane liczby pochodzą z dokumentacji Google Cloud, wymienionej w sekcji „Źródła”.
Architektura TPU v3
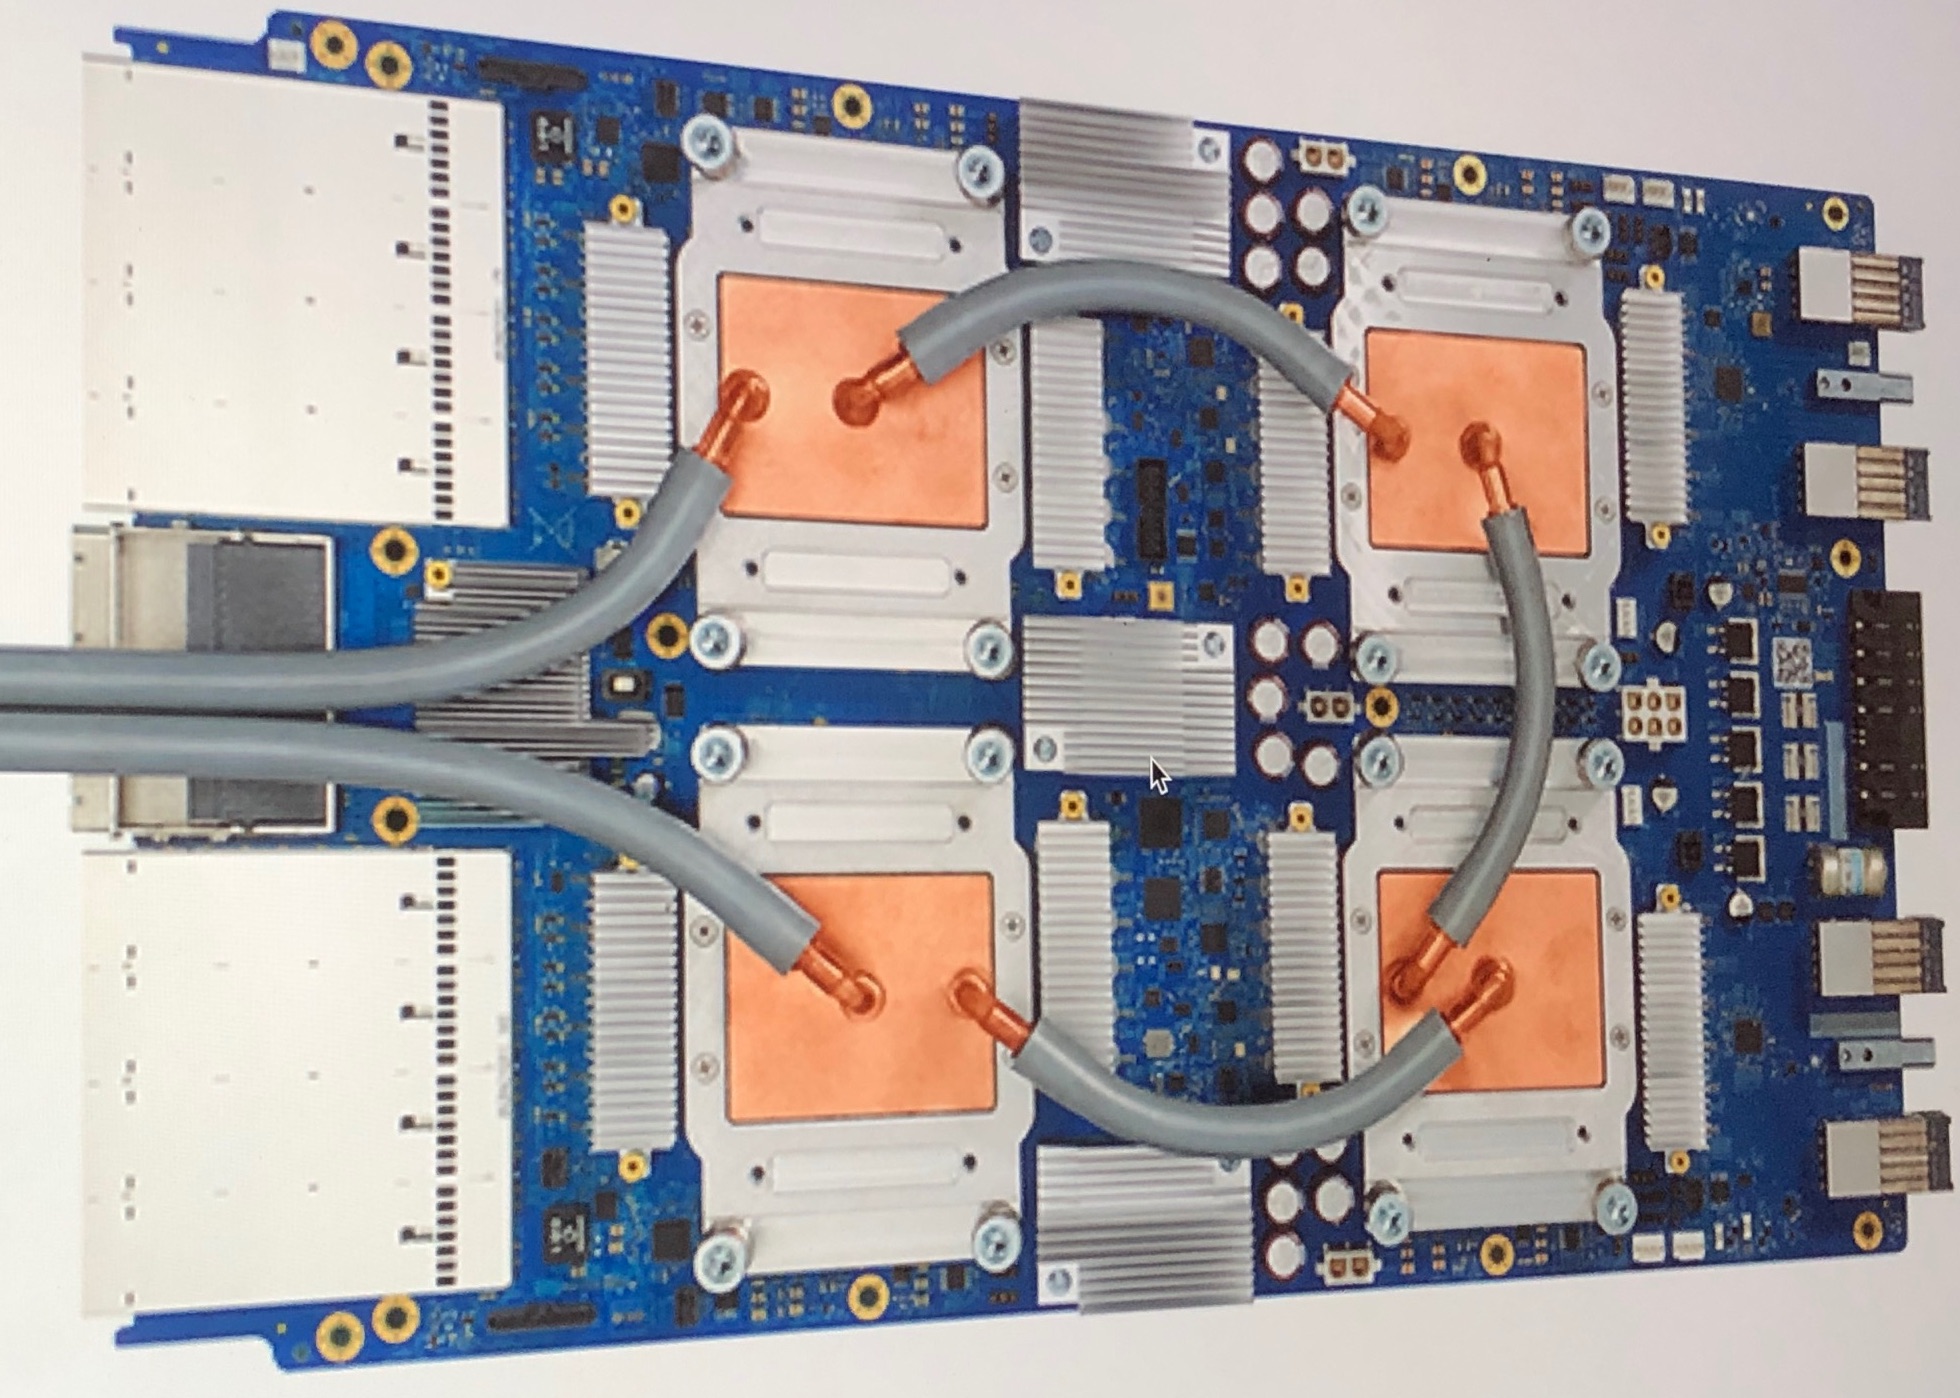
TPU v3 to trzecia generacja akceleratorów Google. Według dokumentacji Google Cloud każdy układ TPU v3 zawiera dwa rdzenie TensorCore, a każdy z nich składa się z dwóch jednostek mnożenia macierzy (Matrix Multiply Unit, MXU), jednostki wektorowej i jednostki skalarnej. Oznacza to cztery jednostki MXU na układ.
Macierze skurczowe (MXU)
Jednostka MXU opiera się na architekturze macierzy skurczowej (ang. systolic array): to duża macierz bezpośrednio połączonych ze sobą układów mnożąco-akumulujących, dzięki czemu dane przepływają przez nią bez ciągłych odwołań do pamięci. W generacjach TPU wcześniejszych niż v6e, w tym w TPU v3, macierz MXU ma wymiary 128×128 jednostek mnożąco-akumulujących. Google podaje szczytową wydajność 123 teraflopów (bf16) na układ.
Pamięć High Bandwidth Memory (HBM)
TPU v3 korzysta z pamięci HBM2 o pojemności 32 GiB na układ i przepustowości 900 GB/s. Pamięć o wysokiej przepustowości jest istotna, bo jednostki MXU muszą być stale zasilane danymi, aby ich moc obliczeniowa mogła zostać wykorzystana.
Chłodzenie cieczą
TPU v3 jest układem chłodzonym cieczą. Chłodzenie cieczą odprowadza ciepło efektywniej niż chłodzenie powietrzem, co pozwala zwiększyć gęstość obliczeniową w szafach serwerowych. Google podaje zmierzoną moc układu TPU v3 (minimalną, średnią i maksymalną) na poziomie 123, 220 i 262 W. Wartości te dotyczą mocy mierzonej dla pojedynczego układu, a nie deklarowanego limitu cieplnego.
Skala klastra (pod)
Według Google pojedynczy pod TPU v3 liczy 1024 układy połączone w topologię 2D torus i osiąga szczytową wydajność 126 petaflopów (bf16).
Podsumowanie
TPU v3 łączy macierze skurczowe MXU, pamięć HBM2 i chłodzenie cieczą w akceleratorze przeznaczonym do uczenia maszynowego w centrach danych. Dokumentacja Google informuje jednocześnie, że Cloud TPU API nie jest już aktywnie rozwijane, a Google zaleca migrację do nowszych wersji TPU. Nie testowaliśmy tego sprzętu; opisujemy go na podstawie dokumentacji producenta.


Dodaj komentarz